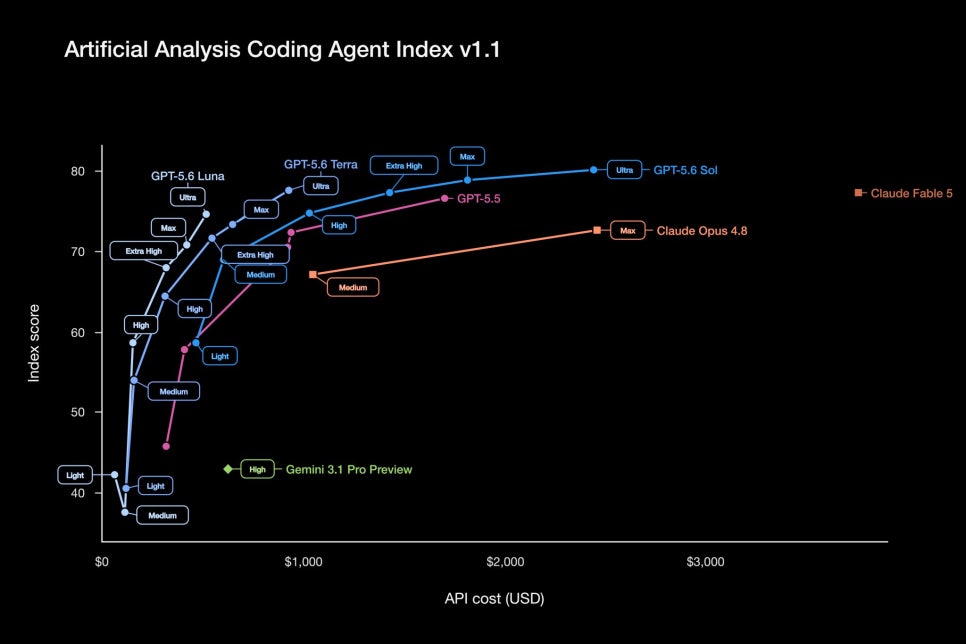
x 에서 이 게시물을 보고 "70점 이상 나오는것을 사용해야겠군" 이라고 생각했다가 codex에서 fast 모드 쓰다 normal 모드로 쓰면 시간 역체감이 심해서 속도도 중요하다는 것을 다시 떠올렸다.(원문 기억이 안나는 점)
OpenAI가 공개한 코딩 에이전트 그래프를 보면 Sol은 높은 품질을 내지만 API 비용이 비싸고, Terra와 Luna는 상대적으로 저렴해 보였다. Luna는 빠르고 경제적인 모델로 소개되지만, 코딩 품질을 얻기 위해 xhigh나 max까지 추론 단계를 올리면 과연 여전히 빠르고 저렴할까?
처음 소개할 때는 Luna > Terra > Sol 순으로 속도가 번개 4->3->2 로 표시됐던것으로 기억하는데 지금은 모두 번개4개로 되어 있다.
모델 설명과 그래프만으로는 판단하기 어려웠다. 그래서 벤치마크 자체를 LLM에 맡겨 보기로 했다.
결과적으로 실험은 세 단계로 확장됐다.
-
동일한 작은 코딩 문제로 모델의 기본 속도와 비용을 비교했다.
-
작은 문제가 실제 개발을 대표하지 못한다고 판단해 Myven의 실제 과제를 다시 실행했다.
-
프로젝트가 커질수록 구현과 리뷰가 반복된다는 점을 반영해 첫 리뷰 수정까지 포함한 멀티턴 비용을 측정했다.
처음부터 이 세 단계를 계획한 것은 아니었다. 앞 단계의 부족함이 다음 실험을 만들었다.
그 과정에서 모델별 성능보다 더 중요한 사실도 발견했다.
코딩 에이전트의 실제 성능은 모델 하나가 아니라 과제, 추론 단계, 테스트, 평가기, 리뷰 루프가 함께 만든 결과였다.
벤치마크
성공 기준
실패 기준
1. 작은 코딩 문제
요구한 패치 구조를 생성하고 TypeScript 동시성 시나리오 4개를 모두 통과
코드가 실행되지 않거나 경쟁 조건·재시도·abort 격리 시나리오 중 하나라도 실패
2. Myven 실제 과제 원샷
제한시간 내 구현 완료, 변경 범위 준수, 문법·정적 검사 통과, 요구 기능 테스트와 숨은 회귀 테스트 모두 통과
주 기능을 구현했더라도 기존 동작 회귀, 안전 조건 누락, 범위 외 변경 또는 숨은 테스트 실패가 하나라도 존재
3. 첫 리뷰 포함 멀티턴
1차 구현 상태에서 첫 리뷰의 차단 이슈 하나만 수정한 후, 동일한 전체 평가를 모두 통과
리뷰 지적이 남았거나 새로운 회귀·기존 범위 위반이 남은 경우. 두 번째 리뷰나 추가 수정 기회는 제공하지 않음
사실 2번째 조건은 가혹하다. 그래서 거의 대부분 결과가….(자세한건
1. 첫 번째 실험: 작은 문제로 속도와 비용을 비교하다
첫 실험의 목적은 단순했다.
모델과 추론 단계만 바꾸고 나머지 조건을 고정했을 때 어느 조합이 빠르고 저렴한지 확인하고 싶었다.
비교한 초기 설정은 다음과 같았다.
-
Luna xhigh
-
Luna max
-
Terra xhigh
-
Terra max
-
Sol high
이후 같은 조건으로 다음 두 설정을 추가했다.
-
Terra high
-
Sol medium
Codex CLI의 codex exec으로 동일한 benchmark-prompt를 직접 실행했다.
조건도 가능한 한 동일하게 맞췄다.
-
service_tier="default"로 일반 모드 사용
-
fast 또는 priority processing 미사용
-
사용자 설정과 MCP 영향을 줄인 임시 세션
-
모델과 reasoning effort만 변경
-
설정별 3회 반복
-
JSONL 이벤트로 실행시간과 토큰 수집
-
응답 형식뿐 아니라 생성된 패치의 실제 동작도 검사
과제는 TypeScript 동시성 버그를 분석하고 수정하는 비교적 작은 문제였다. 모델이 저장소 전체를 탐색하거나 여러 종류의 테스트를 반복하지 않도록 범위를 제한했다. 프롬프트는 다음과 같습니다.
You are participating in a controlled coding-agent benchmark.
Do not use tools. Analyze the TypeScript implementation below. It is intended to provide a TTL cache with single-flight loading, authoritative invalidation, retry after loader failure, and per-caller cancellation that must not cancel the shared load.
type Entry<V> = {
value?: V;
expiresAt: number;
pending?: Promise<V>;
};
export class AsyncCache<V> {
private readonly entries = new Map<string, Entry<V>>();
async get(
key: string,
loader: (signal?: AbortSignal) => Promise<V>,
ttlMs = 1_000,
signal?: AbortSignal,
): Promise<V> {
const current = this.entries.get(key);
if (current?.value !== undefined && current.expiresAt > Date.now()) {
return current.value;
}
if (current?.pending) return current.pending;
const pending = loader(signal).then((value) => {
this.entries.set(key, { value, expiresAt: Date.now() + ttlMs });
return value;
});
this.entries.set(key, {
value: current?.value,
expiresAt: current?.expiresAt ?? 0,
pending,
});
return pending;
}
invalidate(key: string): void {
this.entries.delete(key);
}
}
Return exactly one valid JSON object, with no Markdown fence and no surrounding prose. Keep it under 700 words. Use this shape:
{
"findings": [
{"code": "STALE_RESURRECTION|REJECTION_POISON|SHARED_ABORT", "why": "…"}
],
"patch": "a complete replacement implementation as a JSON string",
"tests": ["exactly four concise test cases"],
"tradeoff": "one concise sentence"
}
Include each finding code only if the code proves it. The replacement must preserve single-flight loading while ensuring: invalidate during an in-flight load cannot repopulate stale data; a rejected load can be retried; one caller aborting does not cancel the shared loader or other callers; an aborted caller rejects promptly.
작은 문제에서는 Sol medium과 Terra high가 강했다
총 21회 실행 결과 중 핵심 비교는 다음과 같았다.
설정
완료시간 중앙값
추정 API 비용
품질
Sol medium
28.37초
$0.09349
3/3
Sol high
38.56초
$0.11242
3/3
Terra high
45.65초
$0.06269
3/3
Terra xhigh
63.55초
$0.07457
3/3
Luna xhigh
100.99초
$0.04319
2/3
Terra max
160.40초
$0.15601
3/3
Luna max
195.42초
$0.07442
3/3
이 결과만 보면 결론은 선명했다.
-
속도 최우선이라면 Sol medium
-
비용과 속도의 균형은 Terra high
-
API 비용만 보면 Luna xhigh
-
max는 추가 품질 없이 추론 토큰과 대기시간만 크게 증가
특히 Sol medium은 Sol high보다 26.4% 빨랐고 16.8% 저렴했다. Terra high도 Terra xhigh보다 28.2% 빠르고 15.9% 저렴했다.
적어도 이 문제에서는 추론 단계를 한 단계 높이는 것이 품질 향상으로 이어지지 않았다.
Luna도 예상과 달랐다. 모델 단가는 저렴했지만 xhigh와 max에서 추론시간이 길어졌다. Luna max는 Terra xhigh와 비용이 비슷하면서 약 3배 느렸다.
이 결과만 놓고 보면 Myven에서도 Sol medium이나 Terra high를 기본값으로 선택하면 될 것 같았다.
하지만 실험을 마치고 나니 한 가지가 마음에 걸렸다.
이 문제가 너무 간단한 것 아닐까?
2. 작은 벤치마크가 부족하다고 느낀 이유
첫 실험은 모델의 추론 속도와 토큰 효율을 비교하기에는 유용했다.
하지만 실제 개발과는 차이가 컸다.
작은 벤치마크에서는 모델이 해야 할 일이 대부분 하나의 문제를 읽고 패치를 만드는 것이었다. 반면 내가 개발 중인 Myven에서는 다음 작업이 함께 움직인다.
-
여러 디렉터리와 기존 구현 탐색
-
GitHub Actions와 셸 스크립트 수정
-
AWS와 Terraform 운영 계약 확인
-
ADR과 런북 업데이트
-
기존 테스트와 새 테스트 실행
-
실패 원인 분석
-
코드 리뷰 반영
-
다시 테스트하고 수정
첫 벤치마크의 총시간은 거의 모델 추론시간이었다.
실제 프로젝트의 총시간은 다르다.
총시간 = 추론 + 저장소 탐색 + 도구 호출 + 테스트 + 실패 후 재작업
프로젝트 규모가 커질수록 뒤쪽 항목이 더 중요해진다. Sol medium과 high 사이의 10초 차이는 전체 테스트가 5분 걸리는 프로젝트에서는 큰 의미가 없을 수 있다.
반대로 high가 medium이 놓친 운영 계약을 한 번에 찾는다면, 호출 자체는 느려도 전체 작업은 더 빨리 끝날 수 있다.
그래서 단순 문제를 반복하는 대신, 전날부터 실제로 진행했던 Myven 세션 기록을 분석하기로 했다.
기존 세션에서 모델별 작업시간을 단순 비교하는 것만으로는 부족했다. 어려운 과제는 Sol high에, 쉬운 과제는 medium에 배정됐을 가능성이 있기 때문이다. 모델 선택과 과제 난이도가 섞여 있었다.
결국 가장 공정한 방법은 과거 과제를 동일한 시작점에서 다시 실행하는 것이었다.
3. 두 번째 실험: 실제 Myven 과제를 다시 실행하다
실제 세션에서 성격이 다른 세 과제를 선정했다.
첫 과제 시작
-
스테이징 환경을 정해진 시간에 켜고 끄는 GitHub Actions 워크플로를 처음 구현하는 과제였다.
플랜에서 구현으로 전환
-
이미 합의된 계획을 바탕으로 스테이징 환경을 다시 켰을 때 기존 PR 배포 이미지를 복원하고, 관련 런타임 계약을 유지하는 과제였다.
리뷰 후 구현
-
AWS IAM 시뮬레이션 응답을 잘못 해석하는 코드 리뷰 지적을 수정하고 테스트를 보강하는 과제였다.
각 과제에는 실제 시작 커밋과 완료 커밋이 존재했다. 시작 커밋으로 독립 저장소를 만들고 다음 여섯 설정에 동일한 과제를 맡겼다.
-
Terra medium
-
Terra high
-
Terra xhigh
-
Sol medium
-
Sol high
-
Sol xhigh
총 18회 실행이었다.
원본 Myven 워크트리를 건드리지 않도록 모든 실행은 git archive로 만든 격리 복제본에서 수행했다. 네트워크, AWS, GitHub 접근과 commit·push도 금지했다.
성공 기준은 “그럴듯한 코드를 만들었는가”가 아니었다
이번에는 평가 기준도 실제 배포에 가깝게 잡았다.
다음 조건을 모두 만족해야 PASS로 처리했다.
-
Codex CLI가 제한시간 안에 정상 종료
-
실제 코드 변경 존재
-
git diff –check 통과
-
허용된 파일 범위 준수
-
문법 검사와 정적 검사 통과
-
요구 기능을 검증하는 테스트 통과
-
모델에게 공개하지 않은 회귀 테스트 통과
이 방식은 SWE-bench의 기능 수정 테스트와 기존 기능 보호 테스트 구조와 유사하다. OpenAI의 SWE-bench Verified도 새 문제를 해결하는 테스트뿐 아니라 기존 동작을 깨뜨리지 않았는지 함께 검사한다.
결과는 2/18이었다
실제 프로젝트 과제에서는 작은 벤치마크와 전혀 다른 결과가 나왔다.
설정
성공
중앙 완료시간
추정 비용 합계
Terra high
1/3
404.7초
$2.72
Sol xhigh
1/3
512.7초
$6.94
Terra medium
0/3
214.6초
$2.13
Sol medium
0/3
244.2초
$3.51
Sol high
0/3
284.0초
$4.62
Terra xhigh
0/3
427.5초
$3.58
18회 중 엄격한 기준을 통과한 것은 두 건뿐이었다.
-
Terra high의 첫 과제
-
Sol xhigh의 첫 과제
하지만 FAIL을 “구현을 전혀 못 했다”로 해석하면 안 된다.
플랜→구현 과제에서 여섯 설정 모두 기존 배포 이미지를 보존하는 핵심 기능을 상당 부분 구현했다. 문제는 Lambda 조회 오류를 진짜 초기 상태로 오인해 ECR 이미지로 fallback하면서 기존 plan-on 실패 계약을 깨뜨렸다는 점이었다.
리뷰 후 구현 과제에서도 모든 설정이 IAM 시뮬레이션의 리소스별 결과를 읽도록 방향을 수정했다. 그러나 선택적 최상위 필드나 비정상 타입 같은 경계 조건을 하나씩 놓쳤다.
따라서 2/18은 모델이 아무것도 하지 못했다는 뜻이 아니다.
한 번의 독립 실행만으로 운영 가능한 상태에 도달한 비율이 2/18이었다.
평가기에도 버그가 있었다
실험 중 평가기의 문제도 발견했다.
일부 구현은 실제 동작이 맞았지만 평가기가 정답 커밋의 step ID나 YAML 표기까지 동일하게 요구했다. on과 "on"처럼 의미가 같은 표현도 한쪽만 허용했다.
평가기를 다음 조건으로 교정했다.
-
시작 커밋은 계속 실패할 것
-
실제 정답 커밋은 계속 통과할 것
-
표면 표현이 달라도 의미가 같은 구현은 통과할 것
Anthropic의 에이전트 평가 가이드에서도 실패 기록을 직접 읽어 모델의 실수인지 평가기의 잘못된 거부인지 확인해야 한다고 설명한다.
이번 실험에서도 모델을 평가하려면 먼저 평가기를 검증해야 했다.
4. 왜 멀티턴 벤치마크가 필요했나
실제 과제 결과가 2/18로 나오자 자연스럽게 의문이 생겼다.
실제 개발은 원샷으로 끝나는 경우가 거의 없다.
프로젝트가 커질수록 구현과 리뷰를 여러 번 반복한다. 첫 구현이 완벽하지 않아도 테스트나 코드 리뷰에서 문제를 발견하고 다시 고친다.
Myven에서도 비슷했다.
-
구현
-
테스트
-
리뷰
-
수정
-
재검증
이 과정이 반복될수록 토큰 사용량과 전체 대기시간이 커졌다.
따라서 원샷 결과만으로는 실제 개발 비용을 설명할 수 없었다. 모델이 첫 리뷰를 받고 문제를 수정하는 데 드는 시간과 비용까지 포함해야 했다.
하지만 멀티턴을 무제한으로 허용하면 또 다른 문제가 생긴다.
추론 단계가 높은 모델은 첫 리뷰에서 지적하지 않은 경로까지 탐색하는 경향이 있었다. 특히 xhigh는 더 많은 관련 경로와 잠재 문제를 발견하면서 실행시간이 계속 늘어날 수 있었다.
그래서 멀티턴 실험에는 명확한 제한을 뒀다.
-
첫 평가에서 발견된 차단 문제 하나만 전달
-
그 문제만 수정
-
새로운 문제를 추가로 조사하지 않음
-
다른 파일이나 범위로 확장하지 않음
-
서브에이전트 사용 금지
-
수정 후 전체 평가를 한 번만 실행
-
다시 실패해도 세 번째 턴은 제공하지 않음
이미 원샷으로 통과한 두 건은 “첫 리뷰 차단 이슈 없음”으로 처리하고 추가 구현시간을 0으로 계산했다.
이 실험이 측정한 것은 무제한 자율 수정 능력이 아니다.
첫 요구를 구현하고, 첫 리뷰에서 지적된 한 문제를 고치는 데 필요한 총시간과 비용이다.
5. 첫 리뷰까지 허용하자 2/18이 6/18로 늘었다
멀티턴 결과는 다음과 같았다.
설정
최종 성공
리뷰 회복
리뷰 추가시간
총시간
총비용
Terra xhigh
2/3
2/3
290.1초
1,707.3초
$4.32
Terra medium
1/3
1/3
228.6초
890.0초
$2.93
Sol high
1/3
1/3
275.3초
1,208.0초
$5.97
Terra high
1/3
0/2
222.8초
1,292.3초
$3.33
Sol xhigh
1/3
0/2
382.1초
1,768.7초
$8.45
Sol medium
0/3
0/3
265.9초
984.4초
$4.99
전체 결과는 다음과 같이 변했다.
-
원샷 성공: 2/18
-
첫 리뷰 후 성공: 6/18
-
첫 리뷰로 회복: 4/16
-
리뷰 수정 추가시간: 1,664.9초, 약 27.7분
-
리뷰 수정 추가비용: $6.49
-
첫 요구와 리뷰를 합친 총시간: 약 2.18시간
-
전체 추정 비용: $29.99
첫 리뷰 한 번이 성공 건수를 세 배로 늘렸다.
하지만 1차 실패 중 회복률은 25%였다. 리뷰를 제공한다고 모든 과제가 쉽게 완결되지는 않았다.
6. 모델보다 과제의 실패 형태가 더 중요했다
멀티턴 결과를 과제별로 나누면 차이가 더 선명했다.
명확한 누락: 5/6 성공
첫 과제는 리뷰 후 최종 5/6이 통과했다.
리뷰 내용은 대체로 다음과 같이 위치와 해결 방법이 분명했다.
-
수동 실행 입력을 on/off 선택형으로 제한
-
스케줄 실행을 기본 브랜치로 제한
이런 문제는 약 36~53초 안에 대부분 해결됐다.
Terra medium, Terra xhigh, Sol high가 리뷰 한 번으로 회복했다. 명확한 누락에는 반드시 xhigh가 필요하지 않았다.
복잡한 fallback 상태 머신: 0/6 성공
플랜→구현 과제는 첫 리뷰 후에도 0/6이었다.
리뷰에서는 다음 조건을 구체적으로 전달했다.
-
access-denied, throttled, none, invalid 응답에서는 실패할 것
-
이 상태를 초기 환경으로 오인해 ECR fallback하지 않을 것
-
두 Lambda가 실제로 존재하지 않는 초기·복구 상황에서만 fallback할 것
그런데 어느 설정도 첫 리뷰 한 번으로 상태 분기를 완결하지 못했다.
리뷰 턴만 설정별 123~261초가 추가됐다. Sol xhigh가 가장 오래 작업했지만 통과하지 못했다.
이 결과는 높은 추론 단계보다 재현 테스트가 더 필요하다는 뜻에 가까웠다.
리뷰 문장을 더 자세히 쓰는 것보다, 각 AWS 응답을 재현하는 fixture와 실패 테스트를 모델이 직접 실행할 수 있도록 제공했어야 했다.
좁은 파싱 경계: Terra xhigh만 성공
리뷰 후 구현 과제에서는 Terra xhigh만 전체 테스트를 통과했다.
Terra xhigh는 비문자형 EvalDecision을 안전하게 실패 처리하라는 리뷰를 77.8초 만에 해결했다.
나머지 설정은 최상위 집계 필드가 선택적이라는 리뷰를 받았지만 이를 정확히 반영하지 못했다.
이번 표본에서 xhigh의 장점이 가장 분명하게 나타난 사례였다.
7. 세 단계에서 모델 순위는 계속 바뀌었다
이번 실험에서 가장 흥미로운 점은 평가 범위를 넓힐 때마다 유리한 모델이 달라졌다는 것이다.
작은 문제
-
Sol medium이 가장 빨랐다.
-
Terra high가 가장 균형이 좋았다.
-
max는 추가 품질 없이 느려졌다.
실제 Myven 원샷 과제
-
Terra high와 Sol xhigh만 각각 한 건 성공했다.
-
Terra xhigh는 가장 많은 추론 토큰을 사용했지만 0/3이었다.
-
단순 문제의 속도 순위가 실제 구현 성공률로 이어지지 않았다.
첫 리뷰 포함 멀티턴
-
Terra xhigh가 2/3으로 가장 많이 성공했다.
-
Terra medium과 Sol high도 명확한 누락을 한 건씩 회복했다.
-
Sol xhigh는 가장 비싸고 오래 걸렸지만 추가 회복은 없었다.
-
복잡한 상태 머신 과제는 전 설정이 실패했다.
따라서 “어느 모델이 가장 좋은가?”라는 질문에는 하나의 답이 없었다.
더 유용한 질문은 다음이었다.
지금 해결해야 하는 실패가 단순 누락인가, 복잡한 상태 분기인가, 아니면 모델에게 보이지 않는 회귀 조건인가?
8. Myven에서의 모델 운용 원칙
이번 결과를 바탕으로 현재는 다음과 같은 운영 방식이 합리적이라고 보고 있다.
첫 구현은 Terra medium 또는 high
작고 위치가 명확한 변경은 Terra medium으로 시작할 수 있다.
여러 파일과 기존 운영 계약을 함께 다루는 과제는 Terra high가 더 안전한 기본값이다.
모든 작업을 처음부터 xhigh로 실행할 근거는 찾지 못했다.
단순 리뷰는 같은 설정으로 한 번 수정
누락된 guard, 잘못된 입력 타입, 명확한 조건문처럼 해결 위치가 분명한 리뷰는 같은 설정에서도 짧은 시간에 회복됐다.
이 경우 모델을 올리는 것보다 리뷰 내용을 좁고 구체적으로 만드는 편이 효율적이다.
복잡한 파싱과 상태 분기는 Terra xhigh로 승격
Terra xhigh는 세 과제 중 두 과제를 최종 통과해 가장 많은 성공을 기록했다.
다만 세 과제에 총 28.5분이 걸렸다. 처음부터 기본값으로 사용하기보다 첫 리뷰에서 문제의 복잡성이 드러났을 때 승격하는 편이 낫다.
첫 리뷰에서도 실패하면 추론 단계를 더 높이지 않는다
첫 리뷰 수정에 실패한 뒤 같은 모델에게 계속 “더 찾아봐”라고 하면 시간과 토큰이 크게 증가할 수 있다.
그때 필요한 것은 더 높은 reasoning effort가 아니라 다음과 같은 피드백이다.
-
실패 재현 테스트
-
실제 입력 fixture
-
기대 상태 전이
-
관련 로그
-
실행 가능한 검증 명령
-
더 작은 과제로의 분해
OpenAI의 Harness engineering 사례에서도 실패를 해결하는 방법은 단순히 에이전트에게 더 노력하게 하는 것이 아니었다. 필요한 제약과 피드백을 모델이 이해하고 검증할 수 있는 형태로 만드는 것이 핵심이었다.
이번 결과에서 Sol의 가격 프리미엄은 정당화되지 않았다
Sol은 작은 문제에서는 가장 빨랐다.
하지만 실제 과제와 멀티턴을 합치면 Sol xhigh는 총 $8.45로 가장 비쌌고, 최종 성공은 1/3이었다. Sol high도 1/3, Sol medium은 0/3이었다.
이번 세 과제에서는 Sol의 높은 단가를 상쇄하는 성공률 이점을 확인하지 못했다.
다만 이것은 Myven의 AWS 운영·자동화 과제 세 건에 대한 결과다. 다른 종류의 작업까지 일반화할 수는 없다.
9. 벤치마크를 LLM에 맡기며 배운 점
처음에는 LLM에게 벤치마크를 설계하고 수행하도록 위임하면 모델 선택에 대한 답을 얻을 수 있을 것이라고 생각했다.
실제로 첫 실험은 답을 줬다.
Sol medium은 빠르고, Terra high는 경제적이며, max는 불필요해 보였다.
하지만 그 답은 작은 문제에만 유효했다.
실제 개발에 적용하려 하자 저장소 탐색과 회귀 테스트가 빠져 있다는 문제가 보였다. 실제 Myven 과제로 확장하자 원샷 성공률이 크게 낮아졌다. 다시 생각해 보니 실제 개발은 원샷이 아니라 구현과 리뷰의 반복이었다. 그래서 첫 리뷰까지 포함한 멀티턴 실험이 필요해졌다.
즉 벤치마크는 다음과 같이 진화했다.
작은 문제의 추론 속도
→ 실제 프로젝트의 원샷 완성도
→ 첫 리뷰까지 포함한 개발 총비용
이 변화는 처음 설계가 잘못됐다는 의미라기보다, 각 실험이 서로 다른 질문에 답했다는 뜻에 가깝다.
-
작은 벤치마크는 모델의 기본 속도와 추론 효율을 보여줬다.
-
실제 과제 재실행은 저장소 수준의 원샷 완성도를 보여줬다.
-
멀티턴 실험은 리뷰 한 번이 성공률과 비용을 얼마나 바꾸는지 보여줬다.
세 결과를 함께 봐야 실제 운용 결정을 내릴 수 있었다.
10. 한계
이번 결과에는 분명한 한계가 있다.
첫째, 설정과 과제 조합당 한 번만 실행했다. 모델 출력의 확률적 변동을 분리하려면 동일 조건을 여러 차례 반복해야 한다.
둘째, 실제 과제 세 건은 모두 Myven의 AWS 운영·자동화 영역에 가깝다. 프론트엔드, 일반 API, 데이터 변환, 단순 리팩터링에서는 결과가 달라질 수 있다.
셋째, 멀티턴에서는 첫 리뷰 한 건만 제공했다. 실제 개발에서는 테스트 출력과 두 번째 리뷰를 제공해 최종 성공률을 더 높일 수 있다.
넷째, 비용은 Codex CLI가 보고한 토큰에 일반 API 가격을 적용한 추정값이다. 실제 구독 또는 API 청구액과는 다를 수 있다.
다섯째, 에이전트 벤치마크는 모델만 측정하지 않는다. 하네스, 제한시간, 격리 환경, 제공 도구도 결과의 일부다. Anthropic도 에이전트 코딩 평가의 인프라 노이즈가 모델 간 점수 차이보다 커질 수 있다고 설명한다.
여섯째, 통계적기법으로는 최소 5회 이상은 수행해야 하는데 토큰이 아까워 자원의 한계로 1회만 실행한 점이 가장 큰 한계인 점을 밝혀둔다.
따라서 이번 결과는 모델의 절대 순위가 아니다.
고정된 Codex CLI 하네스와 제한된 리뷰 예산 아래에서 Myven 과제 세 건을 수행한 결과다.
결론: 모델보다 피드백 루프가 중요했다
처음 알고 싶었던 것은 어떤 모델이 빠르고 저렴한가였다.
작은 문제에서는 Sol medium과 Terra high가 답처럼 보였다.
하지만 실제 프로젝트에서는 다른 질문이 더 중요했다.
-
모델이 기존 계약을 이해했는가?
-
회귀 테스트를 실행할 수 있는가?
-
첫 리뷰에서 문제를 정확히 수정하는가?
-
실패했을 때 더 추론하게 할 것인가, 더 좋은 피드백을 제공할 것인가?
이번 실험에서 높은 추론 단계는 항상 더 좋은 결과를 만들지 않았다.
첫 리뷰는 성공 건수를 2건에서 6건으로 늘렸지만, 복잡한 상태 머신은 어느 설정도 완결하지 못했다. Terra xhigh는 어려운 경계 조건에서 장점을 보였지만 시간 비용이 컸다. Sol은 작은 문제에서는 빨랐지만 실제 과제에서는 높은 단가를 상쇄할 만큼 성공률이 높지 않았다.
Terra high 또는 Sol medium 으로 첫 리뷰에서 실패의 성격을 확인한 뒤 필요한 경우에만 추론 단계를 높인다. 첫 리뷰로도 해결되지 않는 복잡한 문제라면 모델을 높이기 전에 재현 테스트와 피드백 구조를 먼저 개선한다.
코딩 에이전트의 성능은 모델 카드의 점수 하나로 결정되지 않는다.
실제 성능은 모델, 추론 예산, 저장소 구조, 테스트, 평가기, 리뷰 루프가 함께 만든다. 하지만 평가 자동화 또는 LLM 에 완전 위임이 아직도 어려우므로 강력한 루프 하네스를 만들기 힘든게 현실이다. 완전 딸깍의 길은 아직도 저 너머에 있다.
원문 네이버 블로그: https://blog.naver.com/kimjj81/224343943796
답글 남기기